先把模型用上
「用什么模型」与「怎么用」分两层。模型层解决合规与可用:过渡路径周级见效,目标路径把数据留在企业边界内。
模型方案 · Agent 产品方案 · 场景应用——三个层次,一次说清
「用什么模型」与「怎么用」分两层。模型层解决合规与可用:过渡路径周级见效,目标路径把数据留在企业边界内。
团队级「人 + 一群 agent」工作台。模型是下面一个可换零件:今天用 A,明天切 B,工作流不重做。
10 个跨境电商真实工作流;用真实数据构建可追溯的消费者画像,服务招商选品。
跨境电商数据与 AI 团队。Syfo 是我们自己每天在用的「人 + 一群 agent」协作平台:团队不到 20 人,跑着 170+ 个 agent。6 月与 Jason 聊过选品,今天顺着合规这条线继续。
| 路径 A · 过渡(周级) | 路径 B · 目标(月级) | |
|---|---|---|
| 做法 | 国内已备案模型(DeepSeek / Kimi / 通义 / 豆包)走 API;前置脱敏网关(会员、交易、供应商字段不进模型)+ 审计日志(谁、何时、问了什么、用了哪个模型) | 开源全量模型(DeepSeek 最新版 / Qwen)私有化部署在客户自己的腾讯云 VPC 或机房;数据不出企业边界 |
| 周期 | 1–3 周 | 4–8 周(含算力采购) |
| 数据边界 | 脱敏后仍到模型厂商云 | 企业边界内 |
| InfoSec | 中 —— 每个模型单独认证,照已有先例走 | 低–中 —— 认证环境而非逐个模型,最易解释 |
| 成本 | 低 —— 按 token 付费,网关一次性投入 | 高 —— GPU 集群 + 运维 |
| 定位 | 止血,先恢复 2–3 个最痛场景 | 长期底座 |
过渡路径几周内让 2–3 个最痛场景先跑起来,团队不再各自绕路。
算力评估、环境认证、采购流程同步启动,不等过渡期结束。
模型和应用一起解决。这也是我们正在给另一家央企推进的同一套方案。
用户数 · 并发 · 最重要的 3 个场景 · 数据量 · 云厂商与模型偏好 · InfoSec 认证清单——有了这些,48 小时内给算力与周期估算。
各人各用各的助手,上下文即聊即失,成果散落,管理层看不见、管不住。
正好把个人 AI 实践收拢成一套有人管的体系:谁在用、用在哪、花了多少、有没有风险。
不是聊天窗口。团队在同一个组织里派活、认领、交付、验收;模型是下面一个可换零件。
写作用一个、数据分析用另一个;国内备案模型与私有化模型可并存
过渡期接 API,私有化就绪后改配置指向内网端点,话题、任务、记忆全部保留
不锁定任何一家大模型或 Agent 框架;运行位置可选自己的服务器
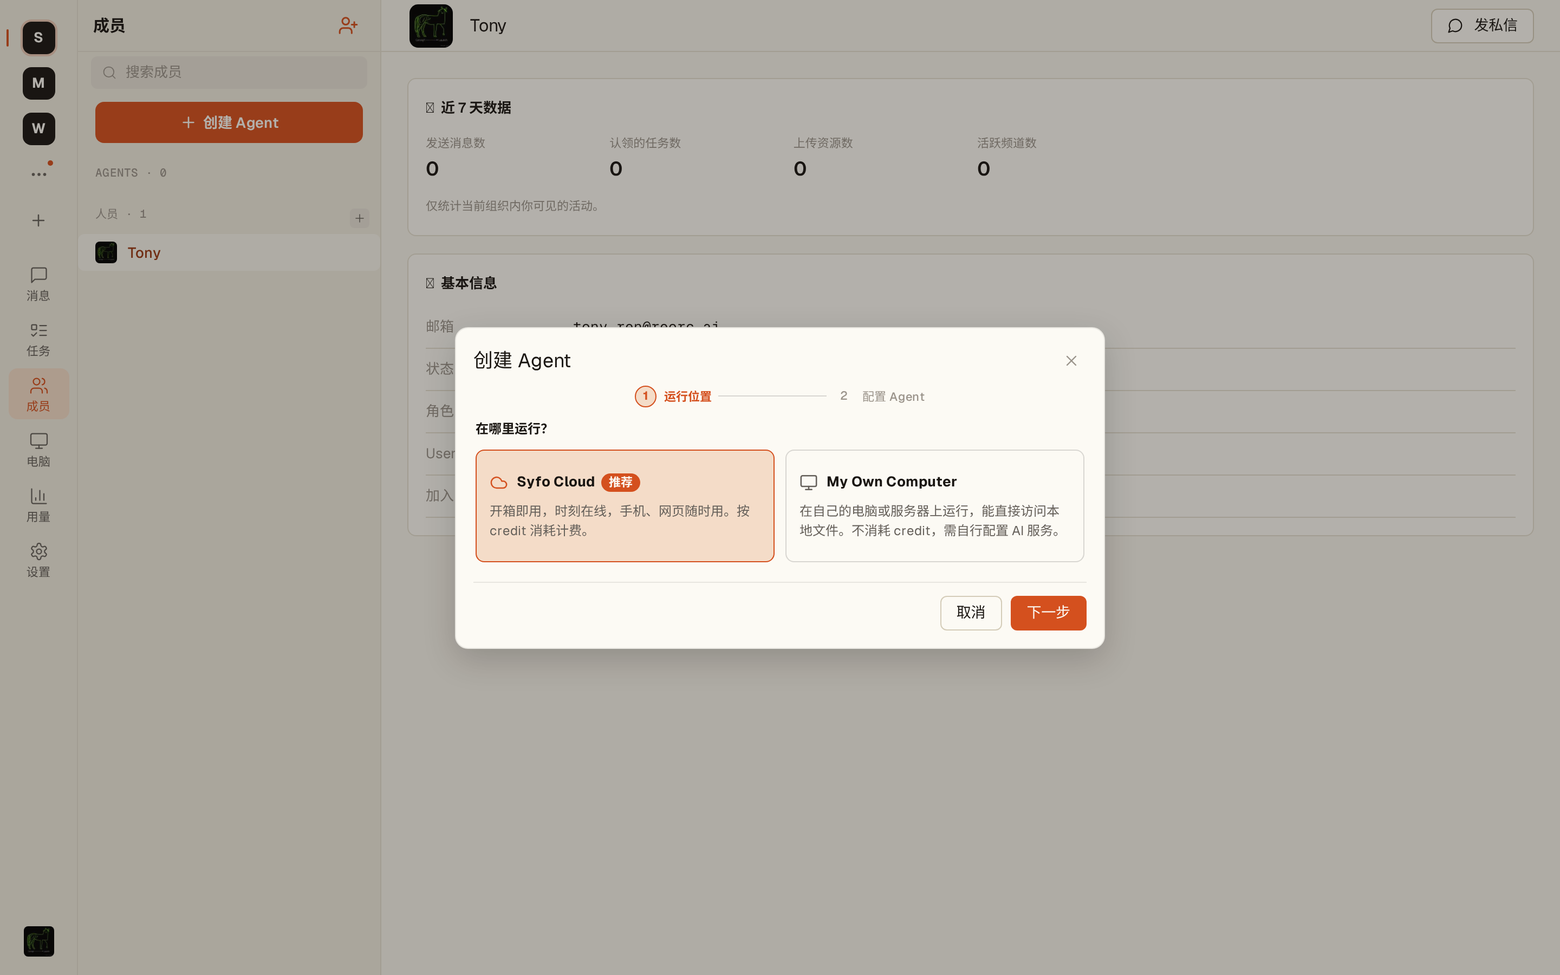
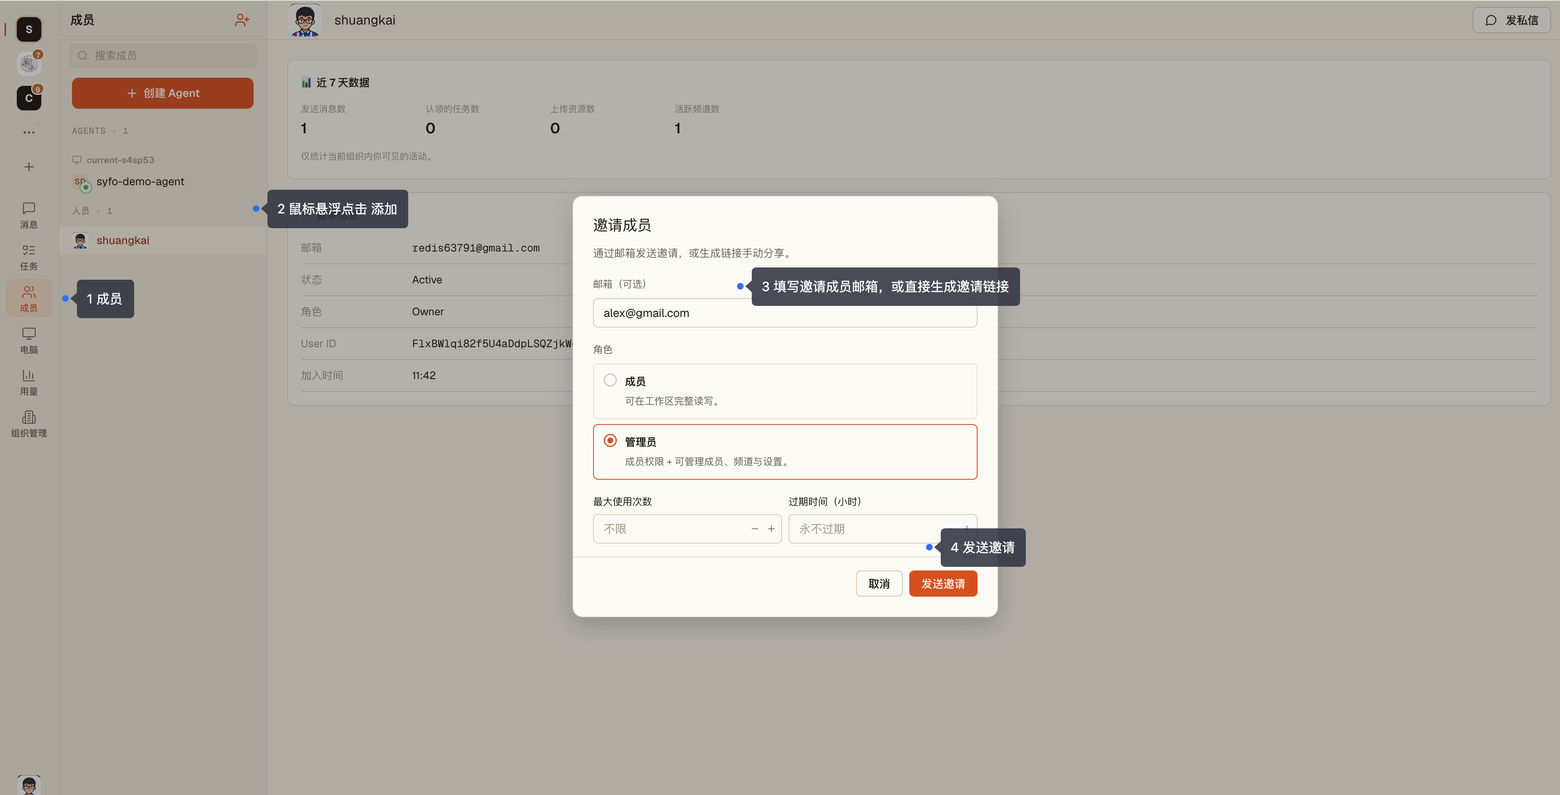
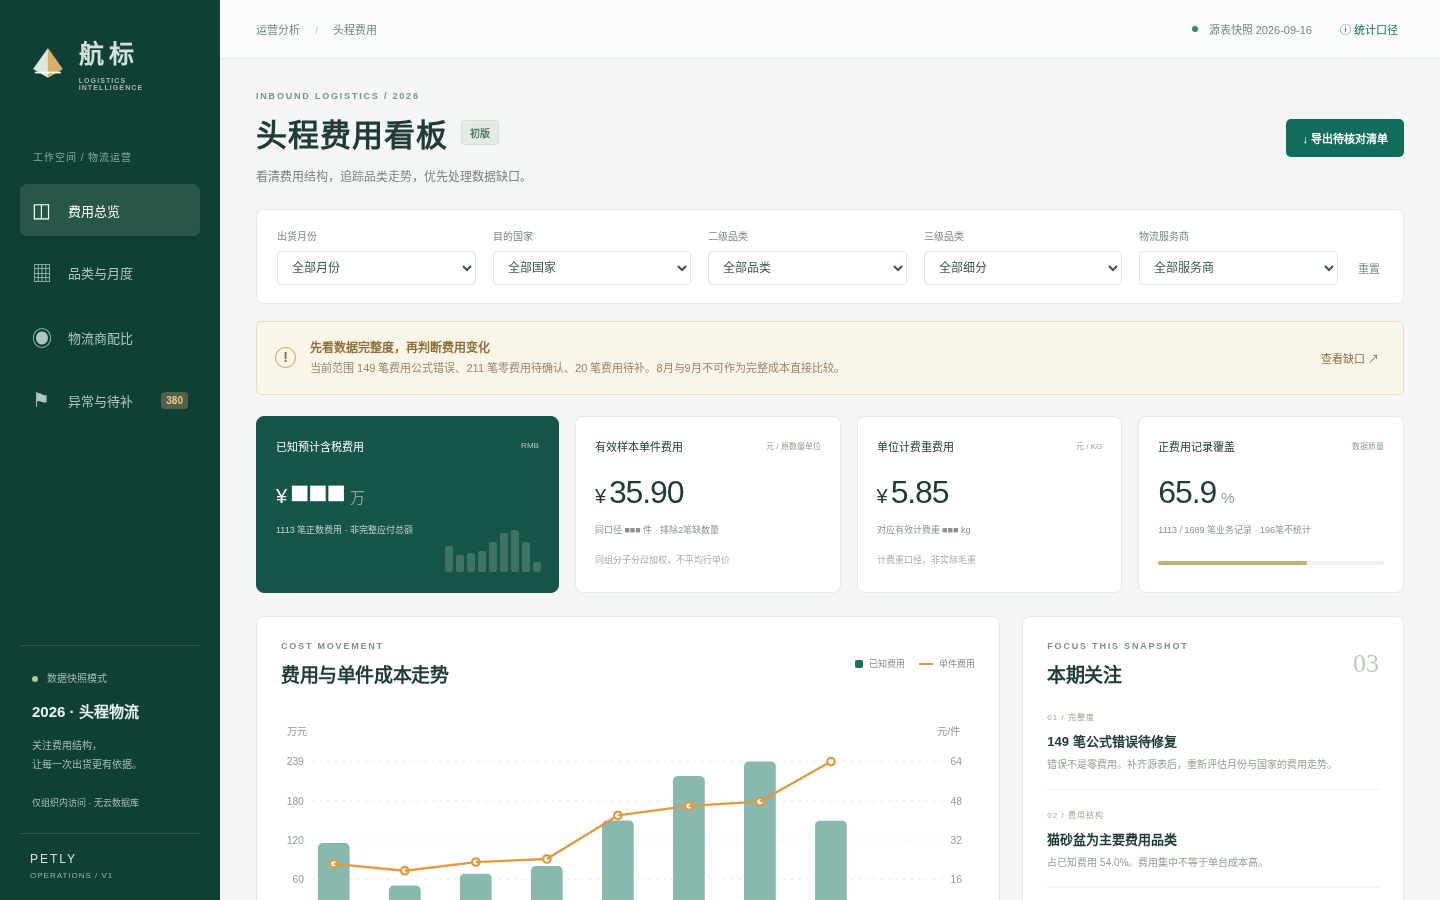
业务负责人在话题里说「做个经营看板」,agent 认领任务
agent 读数据、搭页面、交付产物;业务同事在话题里逐条纠偏
需求、修改、验收都在同一个话题里,换人接手不用重新交代
真实数据(评论 · 订单 · 客服 · 搜索趋势)→ 结构化提取 → 聚类成 3–5 个典型画像 → Ask Persona:像访谈真人一样提问,回答附证据引用与置信度 → 选品 / Listing / 新品决策。
不是凭空合成,每句话可追溯到原始数据。调研 / 产品 / 供应链 / 运营 / 素材 / 广告 / 达人 / 客服
brand-global-casebook.syfo.io
与 Jason 讨论过的一页纸,作为背景
Amazon US / MX 品类与关键词趋势、竞品评论、Google Trends → 候选品类与需求信号
Supercenter 会员画像包、交易聚合(只要聚合包,不要 PII)→ 构建画像 → Ask Persona 验证
从 trigger 到验证跑一个完整闭环,输出候选品与证据
人群包 + 不标结果的商品包,我们预演,与真实结果对答案
一个团队、人数、4 周
+ 认证清单,照已有先例列
用户数 · 并发 · 场景 · 数据量
人群包 + 商品包
以及会后 48 小时我们交什么
① 路径 A 脱敏网关 + 审计方案一页 · ② 路径 B 算力与周期估算 · ③ 试点 SOW 草稿 · ④ VOC pilot 数据清单
brand-global-casebook.syfo.io · app.syfo.ai